AI训练系统:从数据到部署的完整指南
AI训练系统是支撑人工智能模型从原始数据走向实际应用的核心基础设施。它不仅仅是训练一个神经网络那么简单,而是涵盖数据采集与清洗、特征工程、分布式训练、超参数调优、模型评估、版本管理以及最终部署上线的全流程工程体系。一个成熟的AI训练系统,能够显著缩短模型迭代周期,降低算力成本,并保证训练过程的可复现性与稳定性。
在讨论AI训练系统的具体组成之前,先看几个当前最热门的相关关键词:分布式训练、GPU集群调度、自动混合精度、数据并行与模型并行、检查点与容错、MLOps流水线、大模型微调、向量数据库与检索增强训练。这些关键词几乎覆盖了现代AI训练系统最受关注的技术方向。
分布式训练是AI训练系统中最关键的环节之一。当模型参数量从百万级增长到千亿级,单张GPU的显存和算力远远不够。数据并行让每张卡持有完整模型副本,处理不同批次数据,再通过全归约同步梯度。模型并行则将模型本身切分到不同设备上,适合单层参数就超过单卡显存的超大模型。流水线并行进一步按层切分,让不同设备负责不同层段,并通过微批次重叠计算与通信。一个优秀的AI训练系统能够自动或半自动地选择并行策略,并根据集群拓扑优化通信路径。
GPU集群调度决定了训练任务能否高效利用硬件资源。传统作业调度器如Slurm或Kubernetes配合设备插件,可以实现GPU的分配与隔离。但AI训练系统通常需要更细粒度的调度:例如支持抢占式任务、弹性训练(节点故障时自动缩减规模继续训练)、以及拓扑感知调度(将通信密集的任务放到同一台服务器内的NVLink域中)。弹性训练与容错机制结合,使得长时间训练任务不会因为个别节点宕机而前功尽弃。检查点技术定期将模型权重和优化器状态保存到持久化存储,支持断点续训。
自动混合精度是提升训练速度与降低显存占用的常用手段。它让大部分计算使用FP16或BF16,同时保留FP32的主权重副本,并在反向传播时进行损失缩放。现代AI训练系统通常将混合精度作为默认选项,并自动处理数值稳定性问题。配合梯度累积,可以在小批量下模拟大批量训练效果。
数据管道与预处理同样不可忽视。训练系统需要高效地从对象存储或分布式文件系统读取数据,进行解码、增强、打乱和批处理。使用WebDataset、Petastorm或NVIDIA DALI等工具可以避免CPU成为瓶颈。对于大语言模型,数据去重、质量过滤和分词器训练也是训练系统的一部分。
MLOps流水线将训练系统与实验跟踪、模型注册、持续集成和持续部署连接起来。实验跟踪工具如MLflow或Weights & Biases记录每次运行的超参数、指标和产物。模型注册表管理不同版本的模型及其血缘关系。当新数据到达或代码更新时,流水线可以自动触发训练、评估,并在指标超过阈值时推送到推理服务。
大模型微调是当前AI训练系统的热门应用场景。全量微调需要大量显存,因此参数高效微调方法如LoRA、QLoRA、Prefix Tuning被广泛集成到训练系统中。这些方法只训练少量额外参数,大幅降低硬件门槛。训练系统需要支持加载预训练权重、注入适配器、以及合并适配器到基础模型。
向量数据库与检索增强训练代表了训练系统与推理系统的融合。在RAG架构中,训练系统不仅训练生成模型,还负责训练或微调嵌入模型和重排序模型。向量数据库如Milvus、Pinecone或FAISS用于存储文档嵌入,训练系统需要与这些数据库交互,构建高质量的检索训练数据。
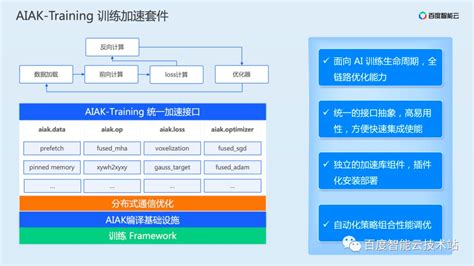
一个典型的AI训练系统工作流程如下:用户提交训练任务描述,包括模型代码、数据集路径、超参数和资源需求。调度器分配GPU节点,启动训练容器。数据加载器流式读取并预处理数据。训练循环执行前向传播、损失计算、反向传播和优化器更新。每隔一定步数,系统评估验证集指标并保存检查点。如果启用弹性训练,系统监控节点健康状态,故障时重新配置通信组并恢复训练。训练结束后,模型产物被注册到模型仓库,并触发评估流水线。最终,通过审批的模型被部署为推理服务。
构建AI训练系统时常见的挑战包括:通信瓶颈导致GPU利用率低,此时需要优化全归约算法或使用NVLink/InfiniBand;显存碎片化导致OOM,可以通过激活重计算或分页优化器缓解;数据加载速度跟不上计算速度,需要增加预取进程或使用更快的存储;以及实验不可复现,需要固定随机种子、记录环境依赖和代码版本。
未来AI训练系统的发展方向包括:更自动化的并行策略搜索、与强化学习结合的在线训练、以及面向多模态数据的统一训练框架。无论技术如何演进,核心目标始终不变:让研究人员和工程师能够更快、更省、更可靠地将数据转化为智能。