AI提示词怎么写?一套通用结构公式和实战示例
同样一款 AI 绘画工具,别人一句话就能出片,你反复改十遍还是差强人意。差别通常不在工具本身,而在提示词(Prompt)。提示词是你和 AI 之间唯一的沟通语言——它不是”许愿”,也不是把想要的东西随口说出来,而是把脑海里的画面翻译成模型能够识别的维度。这篇文章把提示词的结构拆开讲清楚,给你一套可以直接套用的公式,再配上实战对比示例。
为什么你写的提示词,AI 总是”看不懂”
很多人以为写提示词就是”把想要的东西说出来”,于是写下”一个好看的女孩””很有氛围感的风景”这类句子,结果模型只能靠随机来弥补。根源在于:生成模型并没有常识,也不理解你的意图,它只是在海量图文配对中学到了”词汇—视觉特征”的对应关系。你给出的描述越具体、越接近它训练时见过的表达方式,输出就越可控。
换个说法,写提示词的本质,是把一个模糊的想象拆解成一组可以命名、可以量化的视觉属性:是谁、长什么样、穿什么、在哪儿、什么时间、什么光线、什么画风、什么画质。拆得越细,留给模型的随机空间越小,结果就越接近你真正想要的。
反过来,如果你只给一个抽象概念,模型就只能用”平均值”来填空——这就是为什么输入”美女”两个字,出来的图永远是一张没有个性的标准脸。理解了这一点,后面的公式才有意义。
通用结构公式:主体 + 细节 + 环境 + 风格 + 参数
这套五段式公式适用于绝大多数文生图模型,无论你用的是 Midjourney、Stable Diffusion,还是国内的即梦、可灵,区别只在于参数的具体写法。五个维度依次是:
- 主体:画面里最重要的那个人或物,说明它是什么、在做什么。
- 细节:主体的外貌、服饰、动作、材质、表情等具体特征。
- 环境与光线:场景地点、时间、天气,以及光的方向、色温和强弱。
- 风格与媒介:油画、水彩、胶片摄影、赛博朋克插画……决定整张图的调性。
- 画质与参数:分辨率、镜头、比例,以及各平台特有的权重和排除词。
顺序很重要。把权重最大的信息放在最前面,因为模型对靠前词汇的注意力通常更集中。如果画面重点是人物,就把人物描述放在第一段;如果重点是氛围和场景,则把环境和光线往前提。很多人把画面主体塞在句子最末尾,结果模型抓错了重点。
五个维度逐段拆解,附常用词汇
主体要回答”画什么”。尽量避免抽象名词,改用可被视觉化的具体名词,比如把”美食”写成”一碗冒着热气的红烧牛肉面”。
细节是拉开差距的地方。同样是人物,加上”银灰色短发””穿米色针织开衫””侧脸望向窗外”之后,画面立刻有了确定性。细节不必多,三到五个关键特征足够,堆太多反而会互相干扰。
环境与光线决定了整体的情绪。光线是性价比最高的一个词:清晨的薄雾散射光、午后从百叶窗斜射进来的硬光、黄昏的暖橘色逆光,同一主体在三种光线下的观感完全不同。写清楚”室内还是室外、白天还是夜晚、光源在哪里”,画面会立刻立体起来。
风格与媒介负责统一调性。可以从三个角度切入:艺术流派(印象派、装饰艺术)、媒介材质(油画笔触、胶片颗粒、3D 渲染)、参考坐标(某种杂志封面质感、某种电影色调)。选定之后就不要再混搭,风格冲突是出图崩坏最常见的原因之一。
画质与参数是最后的收口。常见的表述包括”超高清””电影级质感””浅景深””35mm 镜头”,再配合宽高比。不同平台的写法差异较大,具体参数建议直接对着你所用工具的说明来调,这一点在主流 AI 绘画工具的对比里讲得比较细。
实战对比:同一个需求,三种写法
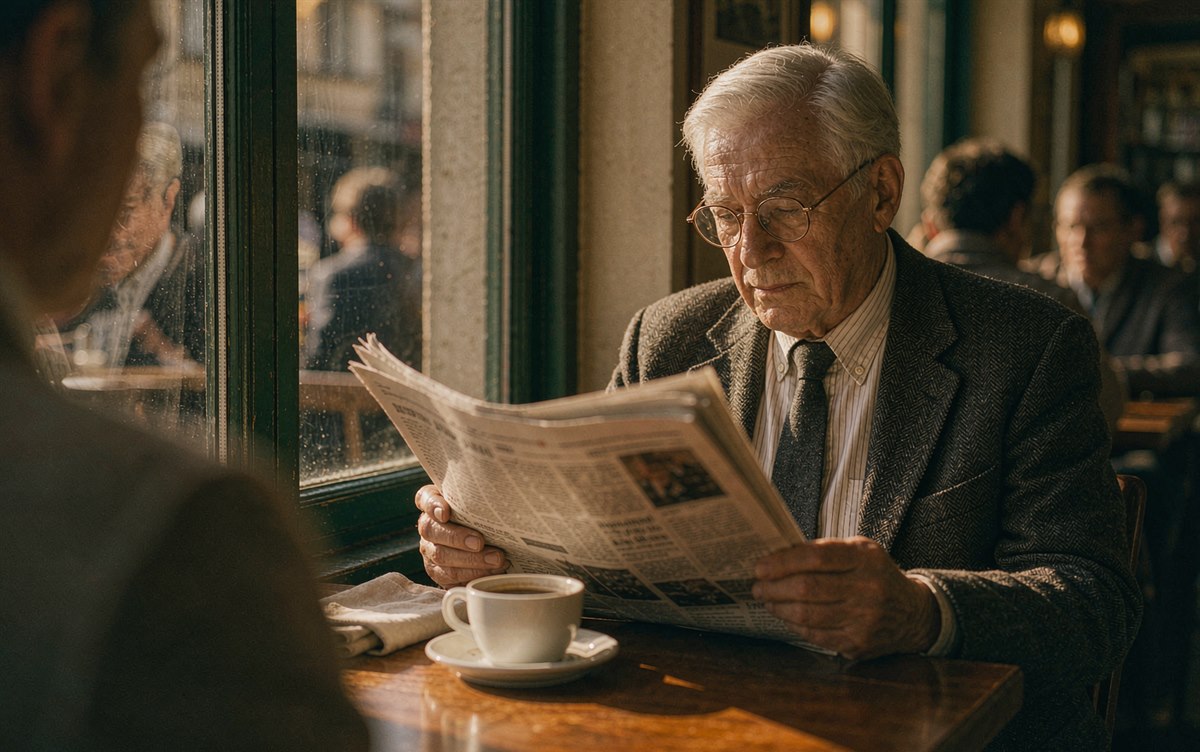
假设需求是”一位老人在咖啡馆里看报纸”,我们来看看三种写法的差距。
初级写法:“老人在咖啡馆看报纸。”模型能识别三个元素,但人物的年龄感、咖啡馆的样子、光线全部靠猜,出图结果极不稳定,换一次种子图就是另一张脸。
中级写法:“一位白发老人坐在窗边的咖啡馆里看报纸,暖色光线,写实风格。”信息量明显提升,光线和风格已经确定,出图基本可用,但画面缺少质感和层次。
完整公式写法:“一位满头银发的老人,戴着圆框眼镜,穿深灰色粗花呢外套,低头阅读一份摊开的报纸,坐在临街咖啡馆靠窗的位置,桌上放着一杯已经凉了的黑咖啡;午后阳光透过玻璃斜射进来,在桌面上形成长条光斑;写实摄影风格,50mm 镜头,浅景深,胶片颗粒质感,超高清。”同样的需求,第三个版本几乎每一次生成都能稳定得到想要的画面。
差别不在于词藻华丽,而在于把每个维度都交代清楚了。这也是专业使用者和新手之间最直接的差距。
五个最常见的提示词错误
- 互相矛盾的描述:比如同时写”写实照片”和”二次元插画”,模型会在两种风格之间摇摆,出图必然四不像。
- 忽略排除类提示:多数模型支持写”不要出现什么”,多余的手指、文字水印、畸形肢体都可以通过排除词抑制,不写就只能靠运气。
- 一次塞进太多主体:三个以上人物或复杂交互,出图失败率会明显上升,建议拆成多张分别生成。
- 把中文直译成英文:部分表达在英文语境里并不对应,容易得到偏题的结果,遇到这种情况可以换成更基础的描述词。
- 写完就跑,不做迭代:出图不理想时,先判断是哪个维度没写清楚,只改那一段,而不是把整句推倒重写,这样才能逐渐找到规律。
结语
提示词不是玄学,它是一套可以被拆解、被复用、被持续优化的结构。刚开始试着套公式会觉得啰嗦,但写熟之后,你脑子里会自动按”主体—细节—环境—风格—参数”的顺序组织语言,出图成功率会有明显提升。建议你先挑一个固定主题连续生成二十张,只调其中一个维度,感受变化,这比盲目抄所谓”万能提示词”有效得多。如果还不确定该从哪个工具入手,可以先看看这份AI 工具清单,再决定主力工具。当静态出图稳定之后,下一步可以尝试用图片生成视频,提示词的写法逻辑是相通的。