AI部署工具:从模型到生产的最后一公里
当我们谈论AI部署工具时,实际上是在讨论一个远比“把模型跑起来”更复杂的工程问题。训练一个模型只是起点,真正的挑战在于如何让它在生产环境中稳定、高效、低成本地提供服务。围绕这个目标,目前主流的AI部署工具大致可以分为几个关键类别。
第一类是通用推理服务器,典型代表是NVIDIA Triton Inference Server和TorchServe。Triton支持TensorFlow、PyTorch、ONNX、TensorRT等多种后端,允许同一个服务实例同时加载多个模型,并且内置了动态批处理、模型版本管理、并发执行和指标监控。它的核心价值在于把推理性能压榨到接近硬件极限,同时保持接口统一。TorchServe则更贴近PyTorch生态,适合快速将PyTorch模型封装成RESTful或gRPC服务,支持自定义预处理和后处理逻辑。
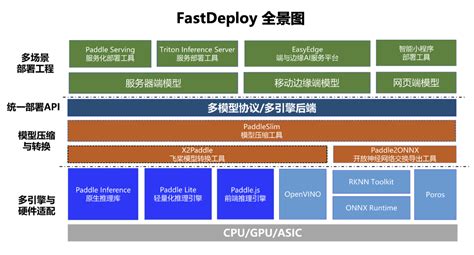
第二类是轻量级运行时和边缘部署工具,比如ONNX Runtime、TensorRT、OpenVINO和TFLite。ONNX Runtime通过统一的中间表示,让模型可以在CPU、GPU甚至NPU上运行,并且提供了图优化、量化、执行提供器切换等能力。TensorRT是NVIDIA的极致推理优化器,能把模型层融合、精度校准、内核自动调优做到极致,但代价是绑定NVIDIA硬件。OpenVINO针对Intel的CPU、集成显卡和VPU做了深度优化,适合在边缘服务器或工控机上部署视觉模型。TFLite则是移动端和微控制器上的首选,支持量化感知训练和训练后量化,能在几MB内存内跑通图像分类或关键词检测。
第三类是面向大语言模型的专用部署框架,比如vLLM、TGI和SGLang。vLLM的核心贡献是PagedAttention,把KV Cache像操作系统管理内存页一样管理,极大提升了吞吐量,并且支持连续批处理和并行采样。TGI是Hugging Face推出的推理服务,集成了张量并行、量化、流式输出和token流控制,适合快速搭建对话式API。SGLang则通过RadixAttention和结构化生成语言,在复杂推理任务上进一步降低延迟。这些工具解决的是传统推理服务器难以处理的长上下文、高并发、动态请求形状问题。
第四类是编排与部署平台,比如KServe、BentoML、Ray Serve和Seldon Core。它们不直接优化单个模型的推理速度,而是解决“如何把多个模型、预处理、后处理、A/B测试、自动扩缩容、金丝雀发布组合成一个可运维的服务”。KServe基于Kubernetes,提供标准化的推理服务CRD,支持Serverless和GPU自动伸缩。BentoML把模型、依赖、API定义打包成一个可部署的“Bento”,然后一键生成Docker镜像或部署到云函数。Ray Serve则擅长组合多个模型和业务逻辑,并且能利用Ray的分布式调度能力做弹性伸缩。
选择AI部署工具时,通常需要回答几个问题:模型是什么框架训练的?目标硬件是什么?请求模式是单次小批量还是高并发流式?是否需要多模型组合?团队是否熟悉Kubernetes?如果只是快速验证,TorchServe或TGI加Docker就够了。如果要压榨GPU利用率,Triton加TensorRT是成熟方案。如果部署大语言模型,vLLM或TGI几乎成了默认选项。如果要在边缘设备上跑,ONNX Runtime或OpenVINO更合适。如果要做生产级多模型服务治理,KServe或BentoML值得投入学习成本。
一个常被忽视的点是:部署工具本身也需要可观测性。Triton暴露Prometheus指标,vLLM提供吞吐和延迟统计,KServe集成日志和追踪。没有这些,你无法判断瓶颈在预处理、模型推理还是后处理。另一个关键是版本管理:模型权重、配置文件、依赖库、推理引擎版本必须一起版本化,否则回滚会变成噩梦。
最后,AI部署工具的选择不是一劳永逸的。模型在迭代,硬件在更新,流量模式在变化。好的部署架构应该允许你替换推理后端而不重写业务代码,比如通过ONNX作为中间格式,或者通过KServe的抽象层。从Triton到vLLM,从ONNX Runtime到TensorRT,工具在进化,但核心目标始终没变:让模型以最低的延迟、最高的吞吐、最少的运维成本,稳定地产生业务价值。