AI系统开发:从架构设计到落地部署的全流程解析
AI系统开发不是简单的模型训练,而是一套覆盖数据、算法、工程、运维的完整体系。很多团队在初期只关注模型准确率,上线后才发现延迟、成本、稳定性才是真正的瓶颈。本文围绕几个热门方向,梳理AI系统开发的关键环节。
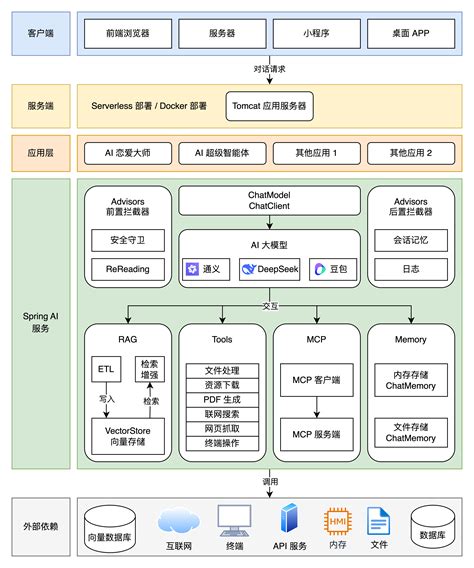
AI系统开发的核心架构通常分为五层。最底层是基础设施层,包括GPU集群、存储和网络。往上是数据层,负责数据采集、清洗、标注和版本管理。第三层是模型层,涵盖训练框架、微调工具和模型仓库。第四层是服务层,把模型封装成API,处理并发、限流和缓存。最顶层是应用层,直接面向业务场景。每层之间通过标准接口解耦,才能支持快速迭代。
数据管道是AI系统开发中最容易被低估的部分。真实场景的数据往往脏、乱、散。一个可靠的管道需要做到:支持批流一体,能处理结构化与非结构化数据;具备数据质量监控,自动发现分布漂移;保留数据血缘,方便回溯问题。很多项目失败不是因为模型不好,而是训练数据和线上数据不一致。建议在开发初期就建立特征存储,统一离线与在线特征的计算逻辑。
模型训练与调优方面,当前主流做法是预训练加微调。对于垂直领域,继续预训练加指令微调往往比从头训练更划算。分布式训练要关注通信开销,数据并行适合大多数场景,模型并行只在参数量极大时才需要。混合精度训练能显著降低显存占用。超参数搜索不要盲目用网格搜索,贝叶斯优化或早停策略更高效。另外,务必记录每次实验的配置和指标,否则复现会非常痛苦。
模型部署与推理优化直接决定用户体验。常见方案有Triton Inference Server、TorchServe、ONNX Runtime等。关键优化手段包括:量化,把FP32转成INT8,速度提升2到4倍,精度损失通常可控;算子融合,减少内核启动次数;动态批处理,把多个请求合并成一个批次,提高GPU利用率;KV缓存,针对自回归生成任务,避免重复计算。对于边缘设备,还可以用剪枝和知识蒸馏。延迟和吞吐往往需要权衡,根据业务SLA来定。
MLOps与持续交付是AI系统开发走向生产级的标志。没有MLOps,模型更新靠手动脚本,迟早出事故。核心实践包括:模型注册表,管理每个版本的模型文件、指标和依赖;自动化流水线,代码提交后自动触发数据验证、训练、评估和部署;影子部署,新模型先接收少量真实流量,对比效果后再全量;监控告警,除了CPU、内存,还要监控预测分布、特征缺失率和业务指标。回滚机制必须能在几分钟内完成。
安全与合规在AI系统开发中越来越重要。对抗样本攻击可以让模型输出错误结果,需要在训练时加入对抗训练。模型窃取攻击通过API查询就能复制模型,可以通过限流、水印或差分隐私来缓解。数据隐私方面,联邦学习允许在不共享原始数据的情况下联合训练。合规上要关注GDPR、个人信息保护法等,确保数据使用有授权、模型决策可解释。对于金融、医疗等强监管行业,还需要保留审计日志。
成本控制是很多团队忽视的维度。GPU资源昂贵,训练任务要设置优先级和抢占策略。推理服务可以根据流量自动扩缩容,低峰期缩到零。模型压缩后可以用CPU推理,成本下降一个数量级。存储方面,冷热数据分层,旧版本模型及时归档。建议每月做一次成本分析,找出浪费点。
总结一下,AI系统开发是一个系统工程。从数据管道到模型训练,从推理优化到MLOps,每个环节都需要工程化思维。不要追求一步到位,先跑通最小闭环,再逐步优化。记住三个原则:可复现、可监控、可回滚。做到这三点,系统才能稳定支撑业务。