AI系统架构:从计算范式到工程落地的全景解析
人工智能系统架构并非单一技术,而是横跨芯片指令集、分布式计算、模型编译、服务编排与数据闭环的复合工程体系。理解它,需要从底层算力一直看到上层业务逻辑。
计算范式层是AI系统架构的基石。当前主流分为三类:以GPU为代表的SIMT架构,擅长处理稠密矩阵运算;以TPU/NPU为代表的脉动阵列架构,针对卷积与矩阵乘优化能效比;以及以存算一体、光子计算为代表的新型范式,试图打破冯诺依曼瓶颈。架构选择直接决定训练吞吐与推理延迟的上限。
分布式训练架构解决的是单卡放不下、单机跑不快的问题。数据并行通过梯度AllReduce同步参数,适合中小模型;流水线并行将网络切层分卡,减少通信量但引入气泡;张量并行在算子内部切分矩阵,通信频繁但扩展性好。混合并行(如3D并行)是千亿参数模型的标配。关键挑战在于通信拓扑与计算重叠——NVLink、InfiniBand、RDMA的选择会改变整个集群的扩展效率。
模型编译与运行时架构负责把训练好的图或算子部署到异构硬件。TVM、MLIR、TensorRT、OpenXLA等框架通过图优化、算子融合、量化、内存复用,将高层模型转换为硬件指令。推理引擎如vLLM、TGI、SGLang引入PagedAttention、连续批处理、投机解码,大幅提升吞吐。这一层决定了单位算力的有效利用率。
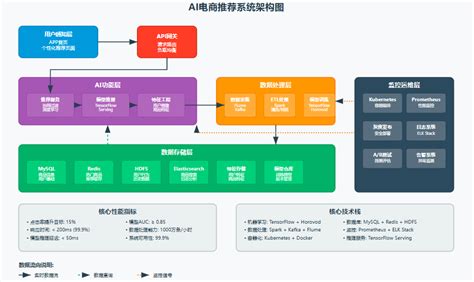
服务与编排架构面向线上生产。典型模式包括:无状态推理微服务加负载均衡;有状态会话缓存加路由;多模型级联或集成;以及Agent架构中的规划器、工具调用、记忆模块。Kubernetes加KServe、Ray Serve、Triton Inference Server是常见组合。关键指标是P99延迟、吞吐、弹性伸缩速度与故障隔离。
数据与特征架构支撑训练与推理的一致性。离在线特征存储(如Feast、Tecton)解决特征漂移;向量数据库(Milvus、Pinecone、Qdrant)支撑RAG与语义检索;数据版本与血缘(DVC、LakeFS)保证可复现。流式架构(Kafka加Flink)用于实时特征与在线学习。
可观测与安全架构贯穿全栈。指标(GPU利用率、显存、队列深度)、日志、链路追踪缺一不可。对抗攻击防御、模型水印、差分隐私、TEE可信执行环境,正在成为AI系统架构的必选项而非可选项。
总结而言,AI系统架构的核心矛盾始终是:算力成本、延迟约束、模型精度、开发效率四者之间的权衡。没有通用最优解,只有面向场景的架构决策。从芯片到服务,每一层的选择都会向上传导,最终决定一个AI系统能否从实验室走向大规模生产。